陈默
-
新突思 Synaptics 推出 Astra SR200 边缘 AI MCU:内置谷歌 Coral NPU + 高带宽定制 DRAM
10 月 20–21 日,Synaptics 发布 Astra SR200 系列 xMCU,采用异构 AI 原生架构,内置 Google Research 的 Coral NPU,并集成可扩展至数百 MB 的高带宽定制 DRAM,首次采用 Arm Cortex-M85 + Cortex-M52 组合,提供最高 400 GOPS 算力;同步推出基于 Astra SR250 的 Coralboard SR 开发板。
-
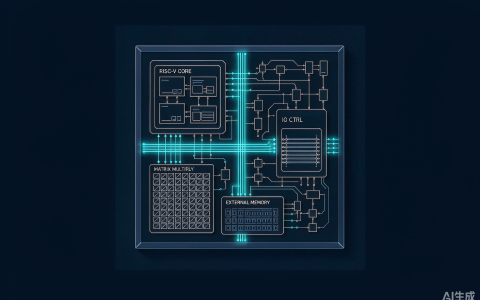
谷歌开源 Coral NPU 完整芯片设计 + 编译器 v1.0:边缘 AI 迈入“开源硬件”时代
10 月 20 日,Google Research 在 GitHub 发布 32 位 Coral NPU 的完整 RTL(硬件逻辑代码)与 v1.0 开源编译器,新增矩阵执行单元(每周期 256 次乘加、最高 1 TOPS、目标 10mW 推理功耗),支持 JAX/PyTorch/TensorFlow 经 StableHLO/TOSA 直接编译。这是大厂首次把“可量产意图”的神经网络加速器设计与软件工具链一并开源。
-
云侧落地加速:谷歌云 Vera Rubin 全面可用、计划部署 96 万块 Rubin GPU;英伟达自测产能翻倍
GTC 柏林同场,谷歌云宣布 Vera Rubin 基础设施全面可用,计划多站点合计部署约 96 万块 Rubin GPU;英伟达预计 2026–2027 半导体测试总产能翻倍,新加坡测试产线 2027 年 2 月大规模投产,后道测试成为交付新约束。
-
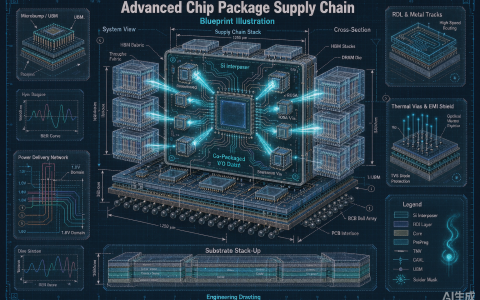
封装与光互联供应链洗牌:三星电机进英伟达基板链,矽品 CPO 产能 2027 冲 15 倍
GTC 柏林同场披露供应链动向:三星电机(SEMCO)正式加入英伟达先进封装基板供应链,2028 年将占据其相当产能份额;矽品(SPIL)与英伟达合作扩产 CPO 共封装光引擎,目标 2027 年中产能提升至当前 15 倍、2028 年底再翻番。
-
英伟达 GTC 柏林收官发布 Vera Rubin DSX POD:集装箱式模块化 AI 工厂,部署从数月压到数天
10 月 21 日 GTC 柏林主题演讲收官,英伟达推出 Vera Rubin DSX POD 全栈模块化 AI 工厂参考架构:预制集成、预测试的集装箱式算力集群,目标把从交付到部署的周期由数月压缩至数天,配套闭环液冷 + 干式冷却实现近零耗水、软件最高降 30% 电耗。
-
英伟达 DGX Station for Windows 发布:GB300 Grace Blackwell Ultra、统一内存最高 748GB、可跑约万亿参数模型
10 月 8 日英伟达发布桌面 AI 超算 DGX Station for Windows,搭载 GB300 Grace Blackwell Ultra 超级芯片,统一内存最高 748GB,可承载约 1 万亿参数模型,计划四季度上市;同期 DGX Spark 64GB 版 10 月 23 日开售。
-
d-Matrix 推出 Squadron 多机架推理集群:内存中心化 XPU + 注意力/FFN 解耦,向 GPU 发起“低延迟”挑战
OCP 2026 上 d-Matrix 发布 Squadron 集群,单集群最多 1024 颗 Corsair XPU,用堆叠 DRAM 把模型状态与 KV 缓存推近算力;并演示 Attention-FFN 解耦,把 FFN 专家卸载到 Corsair 机架、GPU 负责注意力,吞吐显著提升。
-
微软第三代自研推理芯片 Maia 300 亮相:台积电 N2P + HBM4,2027 年冲多吉瓦级部署
10 月 12 日 OCP 峰会上微软发布第三代自研 AI 推理加速芯片 Maia 300,采用台积电 N2P 与 chiplet 架构、8 组 HBM4 共 288GB、单机架 96 颗 / 167kW,号称每兆瓦 token 数比领先 GPU 系统多 40%,并宣布 2027 年起扩至多吉瓦级部署。
-
字节、阿里、腾讯合计订购超 300 万张 RTX PRO 5500,纸面价值超 350 亿美元
路透 10 月 20 日独家:中国三大厂向英伟达下单超 300 万张 RTX PRO 5500 工作站卡(84GB GDDR7、21760 CUDA 核心、出口合规),但英伟达对华仅计划每季 50 万张,实际履约或仅 5%–10%。
-
Groq 下一代 LPU 放弃纯 SRAM:转向 3D 堆叠 DRAM,推理芯片架构迎来“容量”补课
被英伟达约 200 亿美元实质收购的 Groq 被曝在下一代推理芯片中引入 3D 堆叠 DRAM(3DS)。其 LPU 凭 SRAM 做到 150TB/s 带宽、3400 tok/s,但 256 芯片机架仅 128GB——容量见顶,堆叠 DRAM 成为务实解法。