事件内容:同一届 OCP Global Summit(10 月 12 日)上,内存中心化 AI 芯片公司 d-Matrix 发布了 Squadron 多机架推理集群,面向“兆瓦级、低延迟”的 AI 推理,并已开始向优先客户出货。Squadron 最多可将 16 个 SquadRack(每个八服务器机架)聚合成单一集群,承载多达 1024 颗 Corsair XPU。d-Matrix 表示已在亚利桑那数据中心内部署 Squadron,并向精选客户发货。
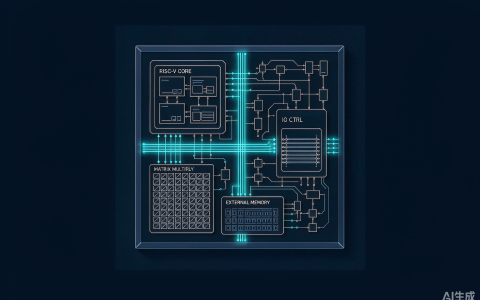
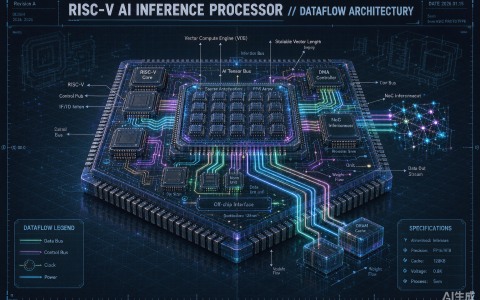
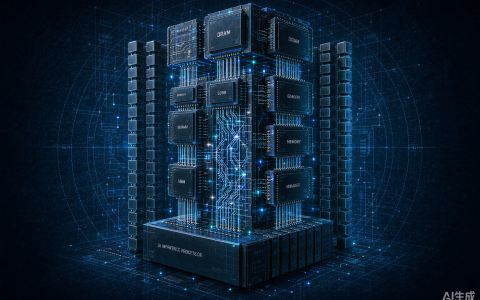
硬件核心是其内存中心化(memory-centric)的 Corsair 加速器:用堆叠 DRAM 与高带宽互联把大模型的模型状态与 KV 缓存尽量推近推理算力,从而降低延迟——d-Matrix 称其在 KV 密集型任务上比纯 GPU 方案延迟更低。现场 d-Matrix 还演示了 Attention-FFN 解耦(AFD):把一个约 200 亿参数模型拆分到 NVIDIA H100 GPU(负责注意力与状态)与 Corsair 节点(负责前馈网络 FFN 专家)上,据称每秒 token 吞吐有明显提升。生态合作方包括 Arista、博通、Supermicro(网络与机架)。d-Matrix 把 Squadron 的目标场景定位在对延迟极度敏感的应用:编程助手、个人智能体、网络安全推理、以及高频交易。
值得关注的原因:
1. 推理硬件正从“唯算力”走向“内存与延迟”。大模型推理里反复读取权重与 KV 缓存,瓶颈在内存带宽与 locality。Corsair 的“把内存堆在算力旁”思路,直击推理的真实痛点。
2. Attention/FFN 解耦是 2026 年最值得跟踪的架构趋势之一。把“状态重”的注意力计算与“无状态、算力重”的 FFN 拆到不同硬件,异构流水线能同时压低延迟与成本——d-Matrix 的演示把它从论文推到了可演示的生产探索。
3. GPU 不会被取代,而是被“配角化”。Squadron 的定位不是干掉 GPU,而是作为 GPU 的异构搭档:在既有 GPU 机架上叠加内存中心化 XPU,形成混合流水线。这对想在不推翻现有投资的前提下降延迟的厂商很有吸引力。
4. 独立验证仍是关键变量。d-Matrix 的吞吐提升目前来自厂商自家演示,公开第三方基准(每 token 能耗、多租户行为、真实经济账)尚未出现,决定了该技术能被多大范围采纳。
5. 赛道已经拥挤。Groq(堆叠 DRAM)、Cerebras(晶圆级)等都在内存侧做文章,d-Matrix 的差异化在于“可叠加进现有 GPU 机架”的异构定位,而非另起炉灶。
来源:The GPU Trade 关于 d-Matrix Squadron 与 OCP 演示的 10 月 12 日报道整理。
原创文章,作者:陈默,如若转载,请注明出处:https://www.chenmo.net/69.html