事件内容:10 月 20 日多家媒体披露,以高速 SRAM 设计闻名的 AI 芯片公司 Groq 正计划在下一代推理芯片中引入 3D 堆叠 DRAM(3DS)封装技术,以摆脱传统 SRAM 在容量上的局限。Groq 由前 Google TPU 设计师 Jonathan Ross 于 2016 年创立,2025 年 12 月英伟达达成约 200 亿美元的协议,涵盖 Groq 知识产权授权与核心人员吸纳,业界普遍将其视为一次“实质收购”。
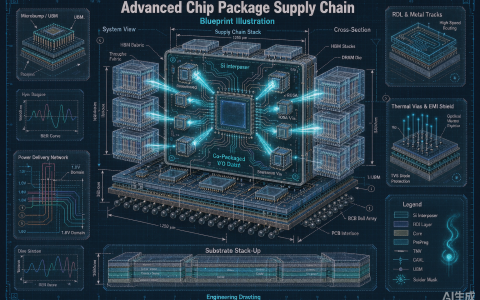
Groq 的成名之作 LPU 走的是极致的 SRAM 路线:Groq 3 LPU 片上集成 500MB SRAM,单芯片带宽高达 150 TB/s(约为同类 GPU HBM 带宽的 7 倍),Groq 3 LPX 据称可实现约 3400 tokens/秒 的推理速度。但代价是容量:一套 256 芯片的 LPX 机架总共只有 128GB SRAM。一旦模型规模冲到千亿、万亿参数,权重根本“装不下”,只能把任务摊到更多芯片上。3DS 方案的思路是用 TSV(硅通孔)把多颗 DRAM 裸片垂直堆叠,像给内存盖起“摩天大楼”,在维持较小芯片面积的同时大幅扩展容量。与高端显卡常用的 HBM 相比,3DS 同样用 TSV 堆叠,但 HBM 追求极致数据速率,3DS 则在保留标准 DRAM 接口协议的前提下,把重心放在容量扩张上——对需要加载海量参数的推理任务更务实。报道还指出,类似走向堆叠 DRAM 的趋势并非 Groq 独有,Cerebras 在其晶圆级芯片 CS-6 上也采用了相近路径。
值得关注的原因:
1. 一次“架构哲学”的转向。Groq 过去的核心主张是“对推理而言带宽压倒一切”。如今转向堆叠 DRAM,等于承认:当模型膨胀到万亿参数,容量已不能再当“别人的问题”。推理芯片设计正在从“唯带宽论”走向带宽与容量并重。
2. 英伟达是这条路线的最大受益者。由于 Groq 技术已实质归英伟达所有,3DS 式内存思路很可能被英伟达吸收进未来的推理硅片,进一步巩固其在复杂大模型推理上的位置。
3. SRAM 的物理天花板被验证。SRAM 虽快,却极占面积;模型越大,容量瓶颈越痛。3D 堆叠成为在“速度”与“装得下”之间取平衡的务实工程解,也为其他推理芯片指明了内存路线。
4. 用“标准接口”换制造确定性。3DS 保留标准 DRAM 接口而非追求极限带宽,本质上是在降低制造与良率风险——对需要大规模铺量的推理芯片,这是比堆参数更现实的降本思路。
5. 保持清醒。该消息源自行业内部人士,尚未获 Groq 或英伟达官方确认;后续要盯的是新 LPU 的容量数字、机架配置是否变化,以及 3DS 能否在补齐容量的同时守住速度优势。
来源:10 月 20 日行业媒体(CryptCortex / 快科技等)关于 Groq 3DS 计划的报道,及 Groq 3 LPU 公开规格整理。
原创文章,作者:陈默,如若转载,请注明出处:https://www.chenmo.net/60.html