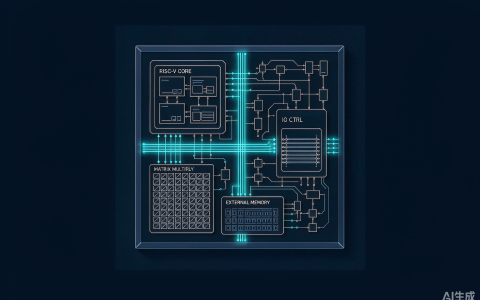
事件内容:在 2026 中国国际工业博览会(CIIF) 上,AI 芯片公司爱芯元智(AXERA)以“智造无界,算力抵达”为主题正式发布 AX8860 大算力边端 AI 芯片系列。这是一颗专为大模型在边缘和端侧落地打造的芯片,纸面指标为:256 TOPS 混合精度算力(原生支持 FP4,无稀疏)、273 GB/s 内存带宽、最高 128 GB LPDDR5X 大容量内存,采用 6nm 先进工艺,内置 16 核 Arm Cortex-A55 与自研 NPU;具备 64 路视频解码、16 路视频编码 能力,支持 AXLink 级联(双芯 512 TOPS、四芯 1024 TOPS,扩展效率约 80%)与 PCIe 5.0 高速互联。
软件侧同步放开:支持 vLLM、SGLang、PyTorch 等主流推理框架,兼容 OpenAI API 服务接口,并配套量化、转换、编译、Profiling、调试的完整工具链。产品形态覆盖模组(元曦 A256S)、单槽 PCIe 卡、单槽四芯方案,并规划 Mini PC 与口袋 PC。官方称该芯片面向“原生 8B/9B/27B 主流边缘大模型”,设定约 30 token/s 吞吐门槛,算力利用率可达 80%,Prefill 阶段性能约为同行的 2 倍。发布现场,合作伙伴原力灵机的 DM0.5 通用具身大脑 即依托该平台完成模型推理,演示了工业插入、灵巧手切削等具身智能任务。
值得关注的原因:
1. 边端大模型“最后一公里”的基础设施。过去大模型靠云端,延迟与带宽成本高;AX8860 把 128GB 内存与 FP4 原生支持塞进单芯片,让 LLM/VLM 在工厂、机器人、物流现场即时推理,符合“数据在哪产生、计算就在哪发生”的物理 AI 趋势。
2. FP4 原生 + 大内存 = 边端跑大模型的钥匙。低精度原生支持压缩权重与 KV 缓存占用,配合大容量 LPDDR5X,是让 27B 级模型在端侧“装得下、跑得动”的关键组合。
3. “均衡而非追峰值”的产品哲学。爱芯元智强调芯片性能由短板决定,刻意不孤立堆某一项指标;在行业普遍卷 TOPS 数字时,这种系统级平衡思路更贴近真实部署。
4. 具身智能 / 物理 AI 的算力底座窗口。与具身大脑 DM0.5 的联动,显示边端大算力正成为机器人从“看得见”到“算得准、反应快、稳定执行”的刚需底座。
5. 保持清醒。纸面算力与真实功耗、现场吞吐仍有差距;30 token/s、80% 利用率多为仿真/目标值,量产交期、多模型适配成熟度与工具链易用性,需看后续真实出货与开发者反馈验证。
来源:爱芯元智官网发布、南方+、工控网、百度百科 AX8860 词条及工博会现场报道整理。
原创文章,作者:陈默,如若转载,请注明出处:https://www.chenmo.net/96.html