陈默
-
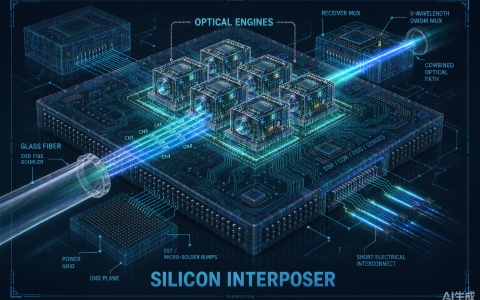
英伟达把“光”塞进硅中介层:OOI 共封装光学亮相,单纤 256Gb/s 破解 AI 集群扩展瓶颈
SEMICON West 2026 上英伟达首席科学家 Nikola Nedovic 首秀 OOI(Optics-on-Interposer)原型:把光引擎从有机基板移到承载 GPU 的硅中介层,关键结构从 100mm 压缩到 8mm,并演示 8 波长 DWDM、单纤 256Gb/s。
-
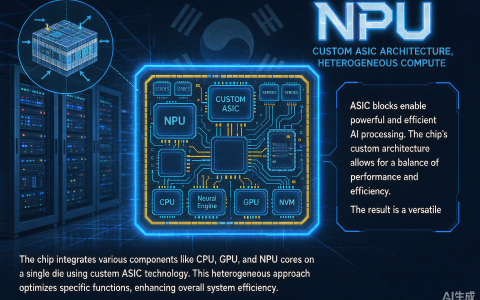
韩国造 NPU 拿下 Lisa Su:Rebellions、FuriosaAI 走出实验室,推理芯片迎“非 GPU”拐点
AMD CEO 苏姿丰 10 月访韩密会 Rebellions、FuriosaAI、DeepX,意在用韩国 NPU 拼异构算力对抗英伟达。Rebellions 日处理 1400 万次请求,FuriosaAI Renegade 已量产出货 4000 颗、仅 180W 风冷——ASIC/NPU 在推理场景开始兑现。
-
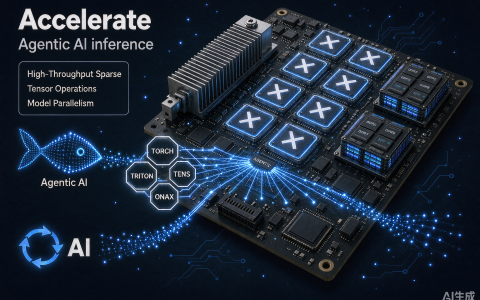
单卡 480GB 显存、350W 风冷:英特尔发布 GPU D 系列推理卡,剑指智能体 AI
代号 Crescent Island 的英特尔 GPU D 系列在 OCP 峰会上正式亮相,首款 D270 基于 Xe3P 架构,最高 480GB LPDDR5X、1.3 PFLOPS FP8、350W 风冷可直接插进现有服务器,专为长上下文与智能体推理设计。
-
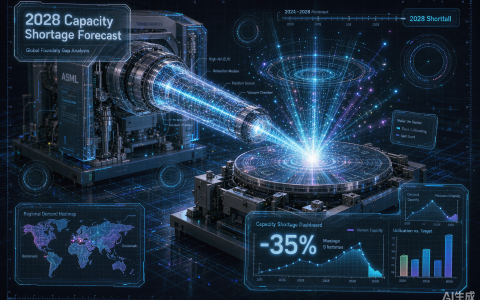
ASML 警告:2027–2028 年光刻机产能已“售罄”,AI 芯片扩产卡在光刻这一环
阿斯麦 Q3 营收 116.6 亿欧元创纪录、净利 49.6 亿欧元超预期,但 CEO 直言 2027、2028 年计划产能都无法满足需求;三星、台积电已承诺采用 High-NA EUV。AI 供应链的瓶颈正从 HBM 转向光刻机。
-
美光官宣研发 EIM 边缘推理内存:为物理 AI 而生的第三类存储,2028 年量产
美光副总裁在韩国半导体展披露:正研发面向物理AI的专用存储 EIM(边缘推理内存),在逻辑芯片上堆叠 LPDDR6,兼顾高带宽与低功耗,瞄准人形机器人、自动驾驶与AR/VR,预计 2028 年下半年量产。高性能人形机器人或需 200GB DRAM。
-
英伟达强推 NVHBM 统一标准:三星被迫首次把 HBM 基底裸片交给台积电 3nm 代工
英伟达要求三星、SK海力士、美光供应 NVHBM 时,基底裸片统一采用台积电 3nm 制造,核心 DRAM 裸片统一 1c 工艺。三星已接受——这是其历史上首次在 HBM 制造环节与台积电合作,HBM 价值链的权力结构被买方改写。
-
英伟达 GTC 柏林开幕:黄仁勋把重心从“卖 GPU”推向“卖 AI 工厂”,物理AI成下一波主线
10月20-22日英伟达 GTC 在柏林举行,黄仁勋 21 日发表主题演讲。本届大会从卖GPU转向输出整套物理AI训练工厂:仿真平台、算力芯片、机器人开发生态打包交付;现场还与德国政府签约,推动制造业转型。物理AI 正式从概念走向产业主线。
-
戴尔手握 950 亿美元 AI 服务器订单却交付不了:内存荒持续恶化,HBM 紧张已逼英伟达考虑给 Rubin Ultra 减层
10月21日戴尔CEO公开表态:内存短缺远未结束,2027 年供应还会更糟。戴尔积压约 950 亿美元 AI 服务器订单创历史新高,卡住交付的是内存而非需求。同日 TrendForce 预估四季度 DRAM 合约价再涨约 20%;因 HBM 吃紧,英伟达考虑把 Rubin Ultra 的 HBM 堆叠从 12 层降到 8 层。
-
华为工程师常驻 DeepSeek 办公室:国产大模型首次参与定义芯片,年底冲万卡昇腾 950DT 预训练
多家媒体 10 月 20 日报道,华为工程师已在 DeepSeek 办公室驻扎较长时间,任务不是软件适配,而是把万亿参数模型训练中的真实瓶颈直接写进华为下一代 AI 芯片的设计决策。DeepSeek 计划最早年底用昇腾 950DT 做大规模预训练——单次任务需逾一万颗芯片连跑数周。
-
谷歌开源 TorchTPU,亚马逊 TorchNeuron 跟进:AI 芯片争夺战从拼算力转向“拆 CUDA 地基”
10月20日,谷歌在 PyTorch Conference 上正式开源 TorchTPU,让 TPU 成为 PyTorch 的原生后端,仅改配置即可把现有应用迁到 TPU;两天前亚马逊已放出 TorchNeuron。三家同周出手,瞄准的都是英伟达真正的护城河——CUDA 软件生态。