10 月 27 日(甲骨文 AI World 大会,拉斯维加斯),Cerebras Systems(NASDAQ: CBRS)与甲骨文宣布达成合作,计划于 2027 年在甲骨文云基础设施(OCI)上提供 Cerebras 高速 AI 推理服务,面向 AI 实验室、企业及开发者。消息公布后,Cerebras 股价盘中一度涨超 10%。
事件核心:晶圆级引擎改写推理速度
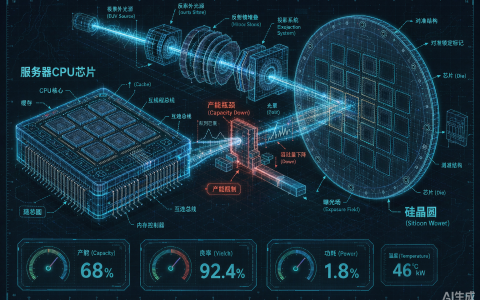
Cerebras 的招牌技术名为 Wafer-Scale Engine(晶圆级引擎)——它不把晶圆切割成一颗颗小芯片,而是把计算与内存直接集成在一整片晶圆级处理器上。这样做的最大好处是大幅减少数据搬运与芯片间通信,从而加速 token 生成。在智能体(agentic)工作流里,模型往往要反复调用自己、分步推理、跨工具执行,每多一次推理就多一层延迟;Cerebras 的架构正是为了压低这类多步骤任务的响应时间而生。
为什么值得关注
第一,推理架构正在从 GPU 单一选项走向”多元菜单”。随着 AI 从训练转向大规模落地,客户更在意响应速度、吞吐与每 token 成本。甲骨文此次一口气把 Vera Rubin(英伟达)、TPU(谷歌)、Cerebras、SambaNova 多类芯片纳入 OCI,使其成为继谷歌云之后首个提供多元 AI 芯片的超大规模云厂商,算力供应链”多极化”再下一城。
第二,专用推理芯片的价值被重估。Cerebras CEO Andrew Feldman 表示:”智能体每走一步都需要推理——无论是思考、核对还是行动。推理越快,AI 能做的有效工作就越多,且不让用户等待。” OCI 总裁 Mahesh Thiagarajan 也强调”AI 推理需要选择”。不过 Cerebras 自 5 月上市以来股价仍跌约 41%,市场对其商业化节奏与产能仍存疑虑,这也是该合作被广泛关注的另一层原因。
对产业而言,晶圆级引擎代表了一条与”堆更多 GPU、用 NVLink 连起来”完全不同的算力路线:用单片超大硅面积换取极致的片内带宽与极低的数据搬运能耗。它的成败,将检验”推理专用架构”能否在通用 GPU 的阴影下真正跑出规模化收入。
原创文章,作者:陈默,如若转载,请注明出处:https://www.chenmo.net/241.html